 Jakub Krystkowiak
Odpowiedź w trzech zdaniach: halucynacja AI to odpowiedź, która brzmi pewnie i poprawnie, ale nie ma oparcia w faktach ani w źródłach, z których model miał korzystać.
Model zmyśla, bo generuje najbardziej prawdopodobny ciąg słów, a sposób jego trenowania i oceniania częściej nagradza zgadywanie niż przyznanie się do niewiedzy. Halucynacji nie da się wyłączyć jednym przełącznikiem, ale w firmie można je mocno ograniczyć: dobrymi źródłami, instrukcją odmowy, wymogiem cytowania, testami i jasnym podziałem odpowiedzialności.
Przykład: pracowniczka HR pyta firmowego asystenta AI, ile dni urlopu na żądanie przysługuje po pół roku pracy. Dostaje: „6 dni, zgodnie z regulaminem pracy”. W regulaminie nie ma takiego zapisu. Odpowiedź ma tę samą pewną formę co trafna, wskazuje nawet dokument. Tego nie widać gołym okiem.
Co to znaczy, że AI halucynuje?
AI halucynuje, gdy podaje nieprawdziwą lub niepopartą informację w formie, która wygląda na wiarygodną. Zmyślona liczba, nieistniejący dokument, cytat, którego nikt nie powiedział, albo procedura, której firma nigdy nie przyjęła.
Halucynacja różni się od zwykłego błędu tym, że model nie sygnalizuje wątpliwości. Człowiek, który nie zna odpowiedzi, zwykle się zawaha. Model językowy pisze płynnie niezależnie od tego, czy ma podstawę.
W firmie najczęściej spotkasz pięć rodzajów:
- fakty: daty, nazwy, warunki umów, które nie istnieją,
- liczby: ceny, rabaty, terminy i wyniki „z pamięci”,
- źródła: odwołania do dokumentów, artykułów albo orzeczeń, których nie ma,
- instrukcje: kroki procedury, których nikt nie spisał,
- streszczenia: wnioski dopisane do dokumentu, który mówi coś innego.
Dlaczego AI zmyśla?
Model nie sprawdza faktów, tylko przewiduje najbardziej prawdopodobny ciąg słów, a w treningu i ocenie zgadywanie zwykle opłaca mu się bardziej niż odpowiedź „nie wiem”.
Badacze Adam Tauman Kalai, Ofir Nachum, Santosh Vempala i Edwin Zhang opisali to we wrześniu 2025 roku w pracy „Why Language Models Hallucinate”. Porównują model do ucznia na trudnym teście: jeśli za brak odpowiedzi dostaje zero, a za strzał ma szansę na punkt, opłaca mu się strzelać.
Autorzy pokazują dwa źródła problemu. Pierwsze jest statystyczne: gdy model nie potrafi odróżnić zdania prawdziwego od fałszywego, błędy pojawiają się naturalnie. Drugie wynika z ocen: popularne testy nagradzają trafienia, a nie nagradzają przyznania się do niepewności.
Dla firmy oznacza to jedno: model, któremu nie dasz źródeł i nie pozwolisz odpowiedzieć „nie wiem”, będzie zgadywał. W burzy mózgów zgadywanie nie szkodzi, przy cenniku albo procedurze BHP szkodzi.
Halucynacja czy nieaktualny dokument?
Sporo „halucynacji” w firmach to w rzeczywistości poprawne odczytanie złego źródła. Jeśli w bazie leżą dwa cenniki, a AI zacytowało ten z 2024 roku, model zrobił, co mu kazano. Błąd siedzi w dokumentach, nie w modelu.
To rozróżnienie oszczędza czas. Zmiana modelu na nowszy nie naprawi starego cennika, a porządek w dokumentach nie pomoże, gdy model dopisuje rzeczy, których nigdzie nie ma. Zanim zaczniesz poprawiać instrukcje dla AI, zadaj trzy pytania:
- Czy odpowiedź wskazuje konkretny dokument?
- Czy ten dokument naprawdę zawiera tę informację?
- Czy to aktualna wersja?
Jeśli odpowiedź na pierwsze lub drugie pytanie brzmi „nie”, masz halucynację. Jeśli „nie” pada dopiero przy trzecim, problemem jest świeżość wiedzy. Jak to uporządkować, opisuje przewodnik Baza wiedzy dla AI: jak przygotować dane firmy, żeby AI odpowiadało trafnie, w części o właścicielach treści i przeglądach.
Dwa publiczne przypadki
Dwie głośne sprawy pokazują, że model zmyśla, ale szkoda powstaje dopiero tam, gdzie zawodzi kontrola.
Kancelaria w Nowym Jorku, 2023. W sprawie Mata v. Avianca prawnicy złożyli w sądzie pismo z nieistniejącymi orzeczeniami i zmyślonymi cytatami, przygotowanymi przy pomocy ChatGPT. Gdy strona przeciwna i sąd zakwestionowały te orzeczenia, prawnicy dalej przy nich obstawali.
Sędzia P. Kevin Castel w postanowieniu z 22 czerwca 2023 roku nałożył karę 5000 dolarów. Zaznaczył przy tym, że korzystanie z wiarygodnego narzędzia AI nie jest samo w sobie niewłaściwe, ale to prawnik odpowiada za dokładność pisma.
Deloitte i australijski departament rządowy (DEWR), 2025. Raport przygotowany przez Deloitte dla australijskiego Department of Employment and Workplace Relations zawierał błędne przypisy i odwołania. Departament opublikował poprawioną wersję z 26 września 2025 roku, która zastąpiła wersję z czerwca, opublikowaną w lipcu.
W zaktualizowanym raporcie końcowym, w części o metodologii, Deloitte ujawniło użycie narzędzia opartego na Azure OpenAI GPT-4o.
Deloitte zgodziło się zwrócić ostatnią transzę wynagrodzenia (kontrakt na 440 tys. AUD), o czym 6 października 2025 roku pisał The Register, powołując się na Australian Financial Review.
W obu przypadkach zmyślone źródła przeszły przez ręce ludzi, którzy podpisali dokument bez sprawdzenia przypisów.
Jak ograniczyć halucynacje w firmie: macierz
Każdej przyczynie halucynacji odpowiada inny sposób ograniczenia i inna osoba, która za niego odpowiada. Poniższa macierz łączy te trzy rzeczy. Czwarta kolumna chroni przed złudzeniem, że jedno ustawienie rozwiązuje problem.
| Przyczyna | Sposób ograniczenia | Kto odpowiada | Czego nie załatwia |
|---|---|---|---|
| Brak informacji w źródłach, model zgaduje | Instrukcja: odpowiadaj tylko na podstawie dokumentów, a gdy ich brak, napisz „nie wiem” i wskaż, kogo zapytać | opiekun systemu AI | nie uzupełnia brakującej wiedzy |
| Odpowiedź bez źródła, nie da się jej sprawdzić | Wymóg cytowania: nazwa dokumentu, wersja, fragment | opiekun systemu AI | model może zacytować źródło nietrafnie |
| Stary lub sprzeczny dokument | Właściciel każdego dokumentu, data przeglądu, archiwizacja starych wersji | właściciel dokumentu | nie powstrzyma zmyślania poza dokumentami |
| Pytania o liczby, ceny, daty, nazwy | Zakaz podawania tych danych z pamięci modelu; tylko z cytowanego źródła albo z systemu (CRM, ERP) | właściciel procesu | nie sprawdzi poprawności danych w systemie |
| Pytanie sugerujące odpowiedź („potwierdź, że…”) | Krótkie szkolenie: pytaj otwarcie, proś o źródła i kontrargumenty | przełożony zespołu | nie zastępuje weryfikacji |
| Zadanie poza zakresem systemu | Jasno opisany zakres: do czego asystent służy, a do czego nie | właściciel procesu | nie zatrzyma użytkownika, który go obejdzie |
| Nikt nie wie, jak często AI się myli | Zestaw pytań testowych sprawdzany po każdej zmianie dokumentów, instrukcji albo modelu | opiekun systemu AI z właścicielami treści | nie wychwyci błędów w pytaniach spoza zestawu |
| Wynik trafia do klienta lub decyzji | Weryfikacja przez człowieka dopasowana do stawki | autor dokumentu i jego przełożony | nie przyspiesza pracy przy treściach wysokiego ryzyka |
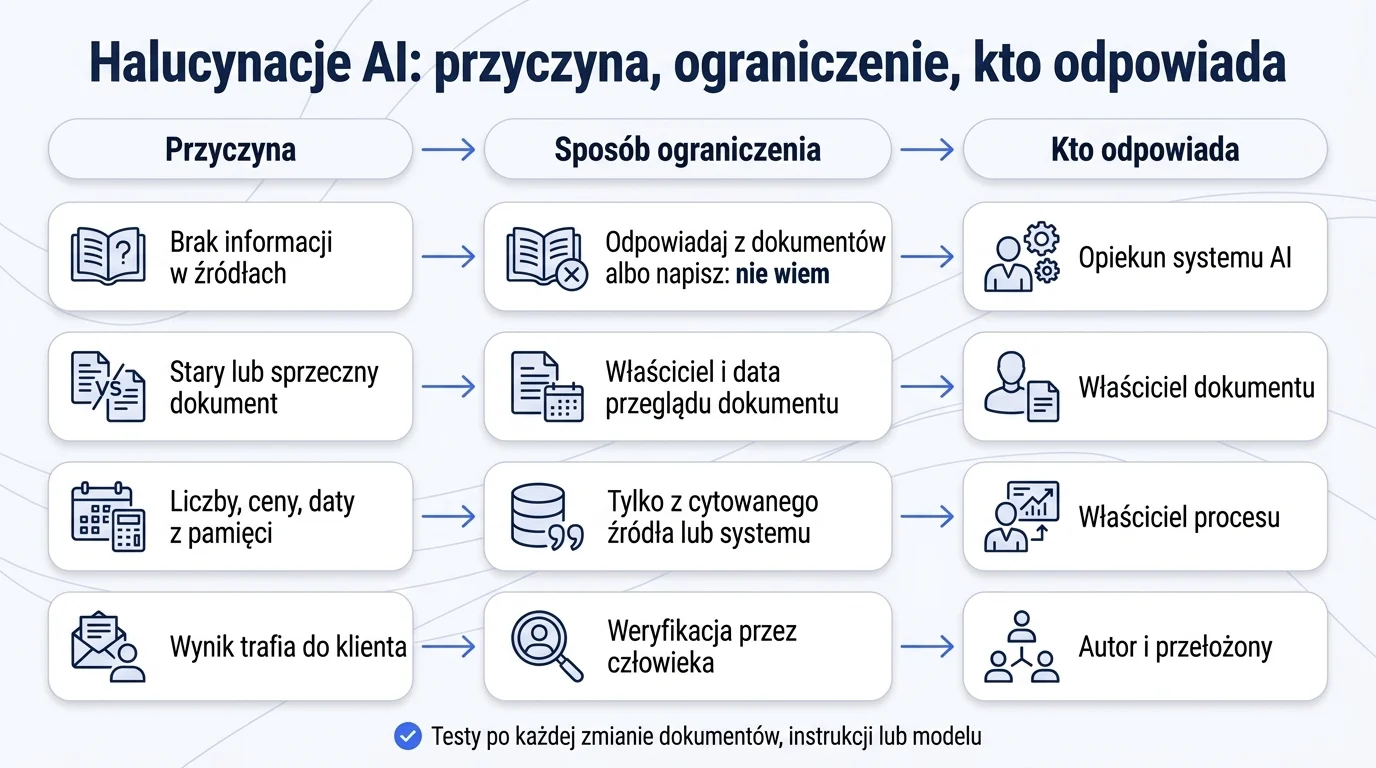
Role w macierzy to propozycja, a nie standard. W małej firmie opiekunem systemu i właścicielem procesu bywa ta sama osoba. Przy każdym wierszu ma stać imię, nie „zespół”.
Dwa pierwsze wiersze wdrażasz jednym akapitem w instrukcji systemowej asystenta. Tak może on wyglądać:
Przykładowy zapis: Odpowiadasz wyłącznie na podstawie dokumentów z bazy wiedzy firmy. Przy każdej odpowiedzi podaj nazwę dokumentu, jego wersję i fragment, na którym się opierasz. Jeśli dokumenty nie zawierają odpowiedzi, napisz: „Nie znalazłem tego w dokumentach firmy” i wskaż osobę z działu, którego dotyczy pytanie. Nie podawaj cen, rabatów, terminów ani danych klientów, których nie ma w cytowanym źródle.
Taka instrukcja zmniejsza ryzyko zgadywania, ale go nie usuwa. Dlatego w macierzy jest też test i weryfikacja. Jak zbudować zestaw pytań testowych i ocenić odpowiedzi, opisuje przewodnik po bazie wiedzy dla AI.
Czy RAG wystarczy, żeby AI przestało zmyślać?
Nie wystarczy, ale przenosi problem z pamięci modelu do jakości dokumentów. RAG to sposób, w którym system najpierw wyszukuje fragmenty firmowych dokumentów, a dopiero potem pozwala modelowi na nich odpowiedzieć. Jeśli wyszukiwanie znajdzie właściwy fragment, model ma się na czym oprzeć. Jeśli znajdzie stary albo niepełny, odpowiedź będzie przekonująca i błędna.
Jak działa ten mechanizm i gdzie zawodzi, wyjaśniamy w tekście RAG po ludzku: jak AI korzysta z dokumentów Twojej firmy.
Jak sprawdzić odpowiedź AI w dwie minuty
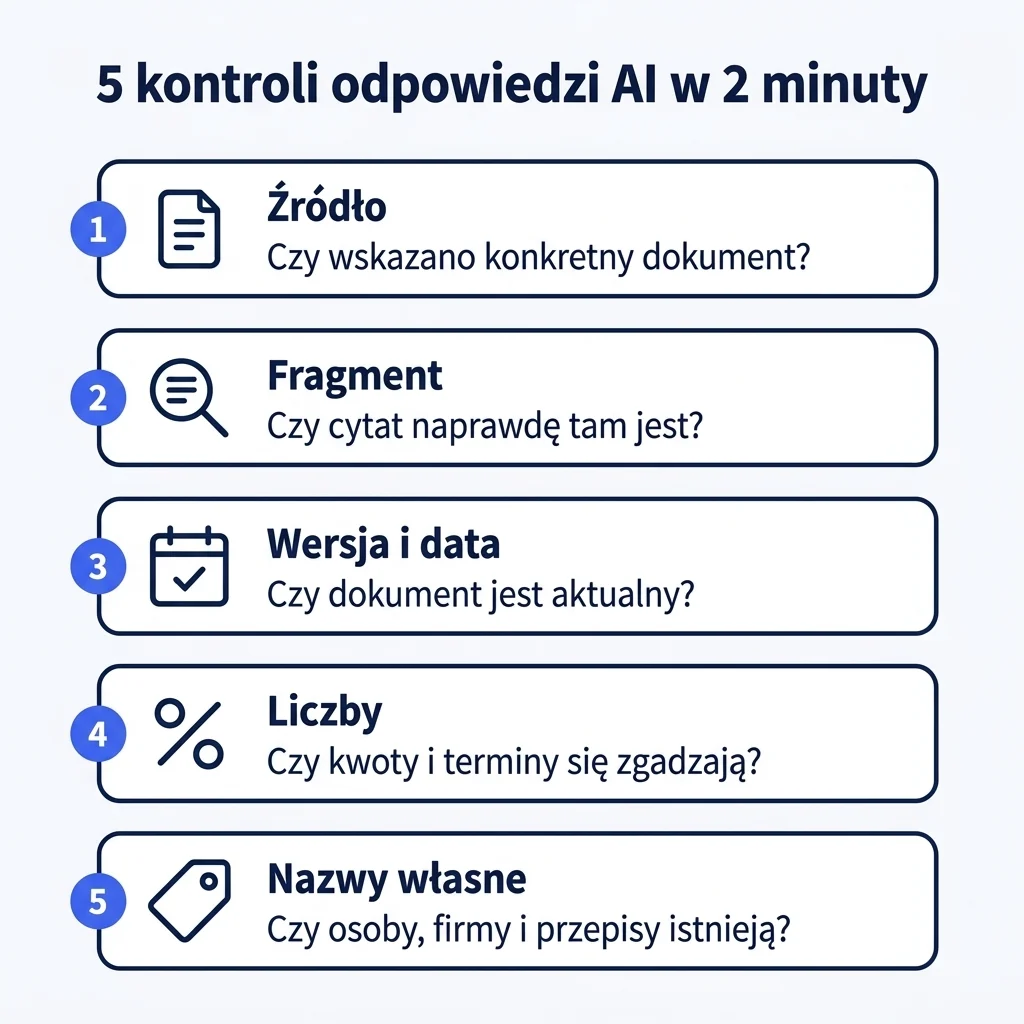
Przed wysłaniem odpowiedzi AI dalej przejdź pięć kontroli.
- Źródło. Czy odpowiedź wskazuje konkretny dokument? Otwórz go.
- Fragment. Czy cytowane zdanie naprawdę tam jest i mówi to samo?
- Wersja i data. Czy to aktualny dokument, a nie zeszłoroczny szkic?
- Liczby. Czy każda kwota, procent i termin zgadza się ze źródłem co do cyfry?
- Nazwy własne. Czy osoby, firmy, produkty i przepisy istnieją i są dobrze nazwane?
Gdy odpowiedź nie przejdzie którejś kontroli, nie poprawiaj jej po cichu. Zgłoś ją opiekunowi systemu. Jedno zgłoszenie to nowe pytanie do zestawu testowego i często sygnał, że któryś dokument wymaga przeglądu.
Kto odpowiada, gdy AI się pomyli?
W praktyce odpowiedzialność ponosi firma i osoba, która wykorzystała wynik, nie narzędzie. Orzeczenie w sprawie Mata v. Avianca mówi to wprost dla prawników, a tę samą logikę warto przyjąć w każdym dziale, który podpisuje się pod dokumentem.
Przy danych osobowych dochodzi RODO. Artykuł 5 ust. 1 lit. d wymaga, by dane były prawidłowe.
Grupa robocza Europejskiej Rady Ochrony Danych ds. ChatGPT zwróciła uwagę w raporcie z 23 maja 2024 roku (pkt 30 i 31), że model ze względu na probabilistyczny charakter może generować informacje zmyślone, a użytkownicy mogą brać je za prawdziwe. Ostrzeżenie o ograniczonej wiarygodności pomaga w przejrzystości, ale samo nie spełnia zasady prawidłowości.
To wstępne stanowisko wobec OpenAI jako administratora, a nie przepis dla każdego wdrożenia. Pokazuje jednak kierunek: dopisek „AI może się mylić” nie przenosi odpowiedzialności. [DO RECENZJI PRAWNEJ]
Zasadę, kto i kiedy sprawdza wyniki AI, warto spisać w jednym miejscu dla całego zespołu. Jak ją sformułować, pokazujemy w tekście Polityka AI w firmie: co powinna zawierać i jak ją wdrożyć (ze wzorem).
FAQ
Czy ChatGPT halucynuje?
Tak. ChatGPT to model językowy, więc dotyczy go ten sam mechanizm co inne modele. Zmyślone orzeczenia w sprawie Mata v. Avianca pochodziły właśnie z ChatGPT, a grupa robocza EROD opisała ryzyko zmyślonych odpowiedzi w raporcie poświęconym temu narzędziu. Odpowiedzi ChatGPT sprawdzaj tak samo jak każdego innego asystenta.
Czy halucynacje da się całkowicie wyeliminować?
Kalai i współautorzy pokazują, że presja statystyczna i sposób oceniania sprzyjają zgadywaniu. Dopóki testy nagradzają strzelanie, realny cel w firmie to ograniczanie i wychwytywanie błędów, nie zero.