 Patryk Nowak
Odpowiedź w trzech zdaniach: baza wiedzy dla AI to uporządkowany zbiór aktualnych dokumentów, procedur i doświadczenia zespołu, w którym każdy materiał ma właściciela, status i datę przeglądu. AI odpowiada trafnie wtedy, gdy znajduje w niej jedną obowiązującą wersję odpowiedzi, a jakość tych materiałów waży tu często więcej niż wybór modelu.
Przygotowanie to trzy rzeczy: porządek w dokumentach (lista 10 punktów poniżej), przypisanie odpowiedzialności za aktualność i test na prawdziwych pytaniach Twojego zespołu.
Przykład: handlowiec pyta firmowego asystenta AI o termin płatności dla klienta hurtowego. Dostaje pewną siebie, dobrze napisaną odpowiedź. Problem w tym, że opiera się ona na regulaminie sprzed dwóch lat, który ktoś zostawił w folderze „Stare, nie ruszać”. Model zrobił dokładnie to, o co go poproszono: znalazł dokument i streścił go. Zawiódł materiał, który dostał.
Ten tekst zajmuje się tą drugą połową. Nie o tym, który model wybrać, tylko o tym, co mu dać do czytania i kto pilnuje, żeby to była prawda.
Czym jest baza wiedzy dla AI
Baza wiedzy dla AI to zestaw materiałów firmy, z których asystent AI czerpie odpowiedzi, opisany tak, żeby system wiedział, co obowiązuje, od kiedy i kto za to odpowiada. Słowo „baza” bywa mylące, bo kojarzy się z jedną aplikacją. W praktyce to częściej porządek niż narzędzie: te same pliki na dysku firmowym mogą być bazą wiedzy albo śmietnikiem, zależnie od tego, jak są opisane.
Warto odróżnić ją od dwóch rzeczy o podobnej nazwie:
- Baza wiedzy uczelni lub biblioteki (to ją zwykle pokazuje Google po wpisaniu samej frazy) to katalog publikacji naukowych. Inny temat.
- Baza wiedzy dla klientów, czyli helpdesk z artykułami w stylu „jak zresetować hasło”, jest pisana dla ludzi, którzy szukają sami. Może być częścią bazy dla AI, ale jej nie zastąpi, bo nie zawiera wiedzy wewnętrznej.
Jak AI faktycznie korzysta z tych materiałów, czyli dzieli je na fragmenty, wyszukuje pasujące i dopiero na ich podstawie pisze odpowiedź, wyjaśniamy w artykule RAG po ludzku: jak AI korzysta z dokumentów Twojej firmy. Tutaj zostajemy przy tym, co firma ma przygotować, zanim cokolwiek zostanie wyszukane.
Co należy do wiedzy firmy: cztery warstwy
Kiedy firma mówi „nasza wiedza”, zwykle myśli o dokumentach. To tylko pierwsza warstwa. Asystent, który zna wyłącznie pliki, odpowiada jak nowy pracownik po przeczytaniu segregatora: poprawnie, ale bez tego, co doświadczeni ludzie wiedzą „z głowy”.
| Warstwa | Przykłady | Gdzie zwykle leży | Ryzyko dla AI | Co zrobić |
|---|---|---|---|---|
| Dokumenty | regulaminy, cenniki, oferty, umowy wzorcowe, specyfikacje | dysk firmowy, załączniki w mailach | kilka wersji tego samego, brak dat | jedna wersja obowiązująca, archiwum oddzielone |
| Procedury | instrukcje stanowiskowe, standardowe procedury operacyjne, checklisty | wiki, pliki, czasem nigdzie | opis zbyt ogólny, brak wyjątków | spisać kroki, warunki i wyjątki |
| Doświadczenie zespołu | „u tego klienta zawsze dzwonimy przed wysyłką”, typowe błędy, skróty myślowe | w głowach ludzi, w prywatnych czatach | AI tego nie wie, więc zgaduje albo milczy | wywiady z ekspertami, notatki ze spotkań |
| Dane z systemów | CRM, system zadań, sprzedaż, analityka | aplikacje firmowe | liczby zmieniają się codziennie | połączenie z systemem zamiast kopii w pliku |
Najtrudniejsza jest trzecia warstwa, bo nie istnieje na piśmie. Tymczasem to ona odróżnia odpowiedź poprawną od odpowiedzi przydatnej. Jak zamienić wiedzę doświadczonych osób w procedurę, z której skorzysta i człowiek, i AI, opisujemy w tekście Procedury w firmie pod AI: jak spisać wiedzę zespołu (SOP, instrukcje stanowiskowe).
Czwarta warstwa wymaga innego podejścia niż pozostałe. Cennik wklejony do pliku w marcu jest we wrześniu nieaktualny. Dane, które żyją w systemach, lepiej podłączyć do asystenta bezpośrednio, niż kopiować je do dokumentów.
Jak pytać AI o takie liczby, na przykład o sprzedaż, CRM czy arkusze, opisujemy w tekście Rozmowa z danymi: jak pytać AI o sprzedaż, CRM i Excela zamiast budować dashboardy.
Dlaczego AI odpowiada źle, gdy wiedza jest w nieładzie?
Bo model nie wie, który dokument obowiązuje, a gdy nie znajduje odpowiedzi, potrafi ją dopowiedzieć. Najczęściej w bazie leżą obok siebie stara i nowa wersja albo dwa sprzeczne dokumenty. Wyszukiwanie wybiera fragmenty najbardziej podobne do pytania, a nie najnowsze, więc model wiernie streszcza zły materiał. Szczegóły tego mechanizmu opisuje artykuł o RAG podlinkowany wyżej.
Dwa pozostałe źródła błędów to luka (odpowiedzi nie ma w materiałach, a asystent nie dostał instrukcji, żeby to przyznać) i wiedza poza bazą, którą zna tylko jedna osoba w zespole. Luka to prosta droga do halucynacji.
Różnica jest praktyczna: nieaktualny dokument naprawia się w bazie wiedzy, a nie w ustawieniach modelu. Skąd biorą się zmyślenia i jakie środki je ograniczają, rozbieramy w artykule Halucynacje AI: dlaczego AI zmyśla i jak to ograniczyć w firmie.
Jak przygotować dokumenty dla AI: lista kontrolna 10 punktów
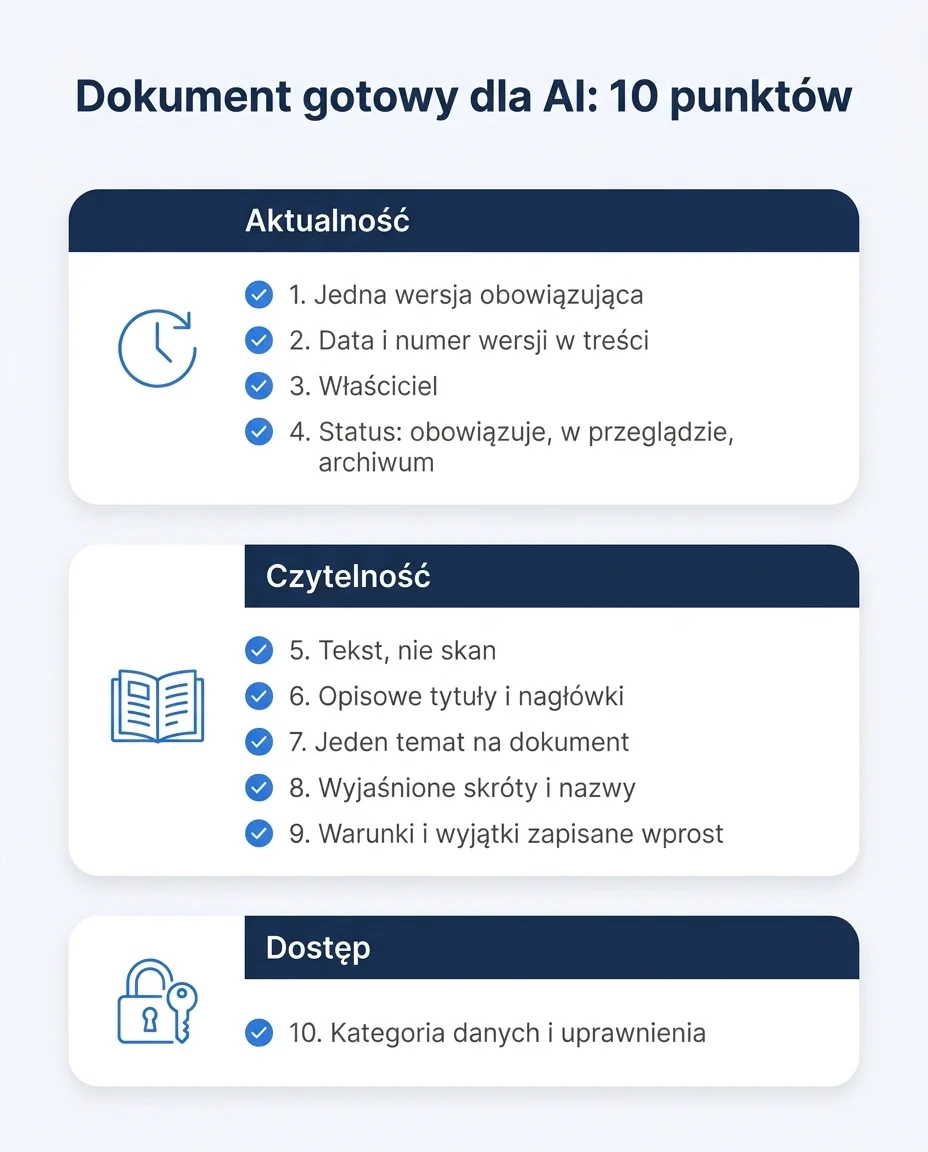
Tę listę możesz przejść z jednym dokumentem w ręku. Każdy punkt ma prosty test, który sprawdzisz bez znajomości techniki.
| # | Kryterium | Jak sprawdzić |
|---|---|---|
| 1 | Jedna wersja obowiązująca | Czy w bazie jest tylko jeden plik z aktualnym cennikiem, regulaminem, procedurą? Starsze wersje leżą w archiwum, poza zasięgiem asystenta |
| 2 | Data i numer wersji w treści | Czy data jest zapisana w samym dokumencie? Sama nazwa pliku albo właściwości to za mało |
| 3 | Właściciel | Czy wiadomo, kogo zapytać, gdy treść budzi wątpliwości? Imię lub stanowisko w nagłówku |
| 4 | Status | Obowiązuje, w przeglądzie czy archiwum? Asystent korzysta tylko z pierwszego |
| 5 | Tekst, nie obraz | Czy da się zaznaczyć i skopiować tekst? Skan bez warstwy tekstowej bywa dla wyszukiwania pustą stroną, a rozpoznawanie tekstu ze zdjęcia nie jest bezbłędne |
| 6 | Opisowe tytuły i nagłówki | Czy tytuł mówi, czego dotyczy dokument? „Terminy płatności dla klientów hurtowych” zamiast „Dokument_final_v3” |
| 7 | Jeden temat na dokument lub sekcję | Czy fragment wyjęty z całości jest zrozumiały? Wyszukiwanie zwraca kawałki, a nie cały plik |
| 8 | Wyjaśnione skróty i nazwy własne | Czy osoba spoza działu zrozumie „ZW”, „klient A”, „ścieżka Kowalskiego”? AI też nie zrozumie |
| 9 | Warunki i wyjątki zapisane wprost | Czy jest „jeśli zamówienie powyżej X, to…” zamiast „w uzasadnionych przypadkach”? |
| 10 | Kategoria danych i uprawnienia | Czy wiadomo, kto może zobaczyć dokument i jakie dane zawiera? |
Ostatni punkt łatwo przeoczyć, a jest ważny. Asystent nie powinien pokazywać handlowcowi umów z działu kadr tylko dlatego, że leżały w tym samym folderze. Dostęp w bazie wiedzy powinien odpowiadać dostępowi w źródle.
Seria nodash_ stosuje cztery kategorie danych: materiały publiczne, dane wewnętrzne, dane osobowe i poufne oraz hasła i klucze API. Te ostatnie nie trafiają do bazy w żadnej formie. Pełne zasady opisuje artykuł Polityka AI w firmie: co powinna zawierać i jak ją wdrożyć (ze wzorem).
Punkty 2 do 4 najwygodniej zebrać w krótkim nagłówku na początku każdego dokumentu. Część narzędzi potrafi z takich informacji korzystać wprost, jeśli zapiszesz je także jako atrybuty pliku, obok jego treści: na przykład OpenAI file search łączy wyszukiwanie semantyczne z wyszukiwaniem po słowach kluczowych i pozwala filtrować wyniki po takich atrybutach (stan dokumentacji na 3 października 2026). A nawet bez takiej funkcji nagłówek ułatwia życie ludziom.
Przykładowy zapis: Terminy płatności dla klientów hurtowych | Wersja 4 | Obowiązuje od 1.09.2026 | Status: obowiązuje | Właściciel: główna księgowa | Następny przegląd: 1.03.2027 | Kategoria danych: dane wewnętrzne | Dostęp: sprzedaż, księgowość
Kto odpowiada za aktualność wiedzy: model właściciela i świeżości
Lista kontrolna porządkuje bazę raz. Bez kogoś, kto odpowiada za jej aktualność, po pół roku wraca do punktu wyjścia, tylko że teraz stare odpowiedzi podaje pewny siebie asystent. Dlatego każda treść w bazie potrzebuje właściciela, a cała baza opiekuna.
W większości firm sprawdzają się do tego trzy role:
- Właściciel treści to osoba, która zna temat i zatwierdza zmiany: dyrektor sprzedaży dla rabatów, główna księgowa dla terminów płatności. Nie musi niczego technicznie wgrywać.
- Opiekun bazy pilnuje terminów przeglądów, przenosi wersje do archiwum i nadaje dostępy. W małej firmie to często ta sama osoba, która opiekuje się narzędziami AI.
- Każdy użytkownik zgłasza błędną odpowiedź asystenta jednym kliknięciem albo wiadomością. Te zgłoszenia są najtańszym źródłem informacji o tym, co się zestarzało.
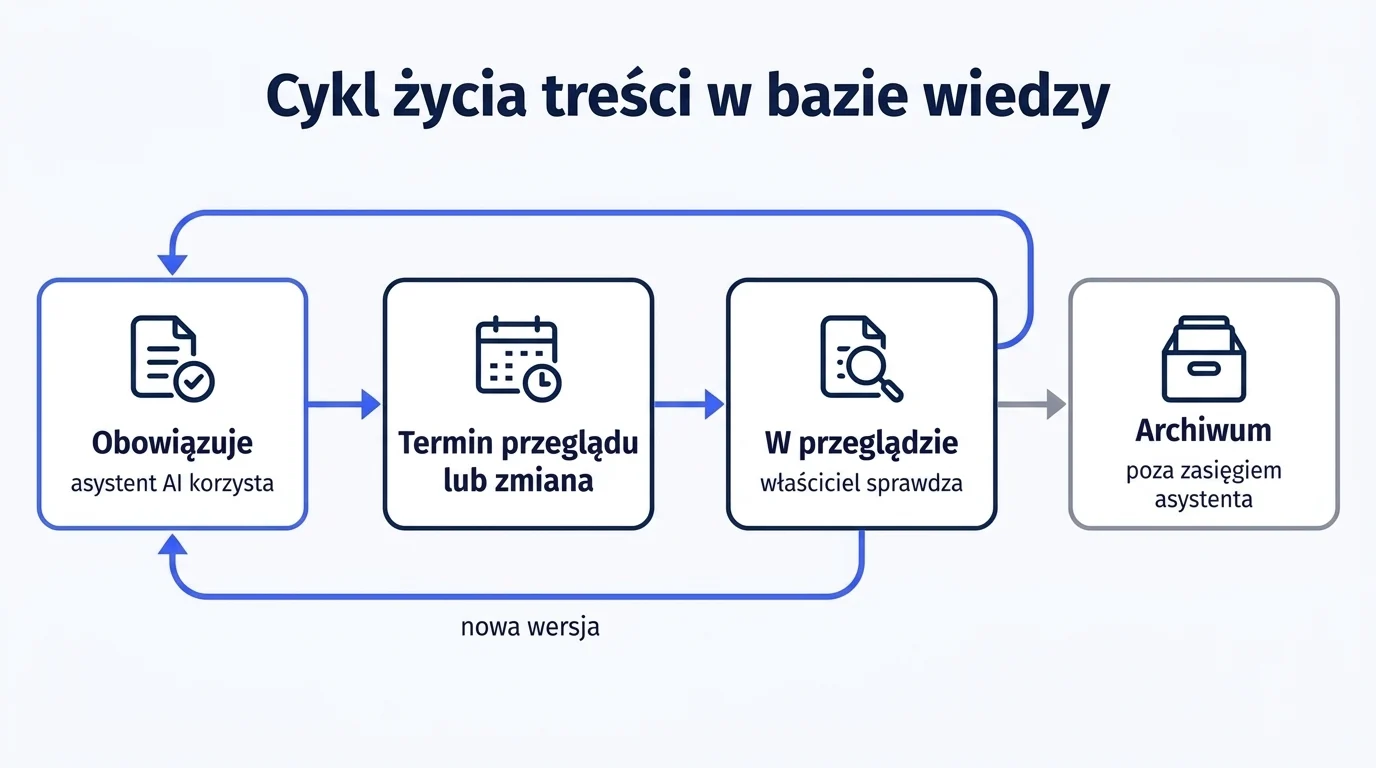
Każdy materiał ma jeden z trzech statusów: obowiązuje (asystent z niego korzysta), w przeglądzie (minął termin albo coś się zmieniło, asystent korzysta, ale z ostrzeżeniem lub wcale, zależnie od wagi treści) oraz archiwum (zostaje dla historii, poza zasięgiem asystenta).
Poniższe częstotliwości to przykład do dopasowania, a nie norma. Rytm przeglądów zależy od tego, jak szybko zmienia się Twoja branża.
| Typ treści | Właściciel (przykład) | Przegląd (przykład) | Wyzwalacz zmiany poza terminem | Co po upływie terminu |
|---|---|---|---|---|
| Cenniki, rabaty, warunki handlowe | dyrektor sprzedaży | co miesiąc lub przy każdej zmianie | nowy cennik, promocja | status „w przeglądzie”, asystent odsyła do opiekuna |
| Regulaminy, umowy wzorcowe | osoba od spraw prawnych | co 6 miesięcy | zmiana przepisów, nowa wersja umowy | status „w przeglądzie”, odpowiedź z ostrzeżeniem |
| Procedury operacyjne | kierownik procesu | co 6 miesięcy | nowe narzędzie, zmiana zespołu, powtarzający się błąd | właściciel potwierdza lub poprawia |
| Opisy produktów i usług | product manager | co kwartał | nowa wersja produktu | aktualizacja przed premierą |
| Notatki i ustalenia z klientami | opiekun klienta | przy każdym spotkaniu | zmiana warunków współpracy | starsze ustalenia oznaczone datą |
Najprostsza zasada: materiał bez właściciela nie trafia do bazy. Brzmi surowo, ale chroni przed najczęstszym scenariuszem, w którym dokument „wszystkich” po roku nie należy do nikogo i nikt go już nie poprawi.
Jak sprawdzić, czy AI odpowiada trafnie: test na pytaniach Twojego zespołu
Trafność sprawdza się na prawdziwych pytaniach, które zespół zadaje w pracy, z odpowiedziami wzorcowymi przygotowanymi przez ludzi, a nie na wrażeniu z kilku rozmów. Ogólne rankingi modeli mówią, jak model radzi sobie z cudzymi zadaniami. O tym, czy zna terminy płatności w Twojej firmie, powie dopiero Twój własny zestaw.
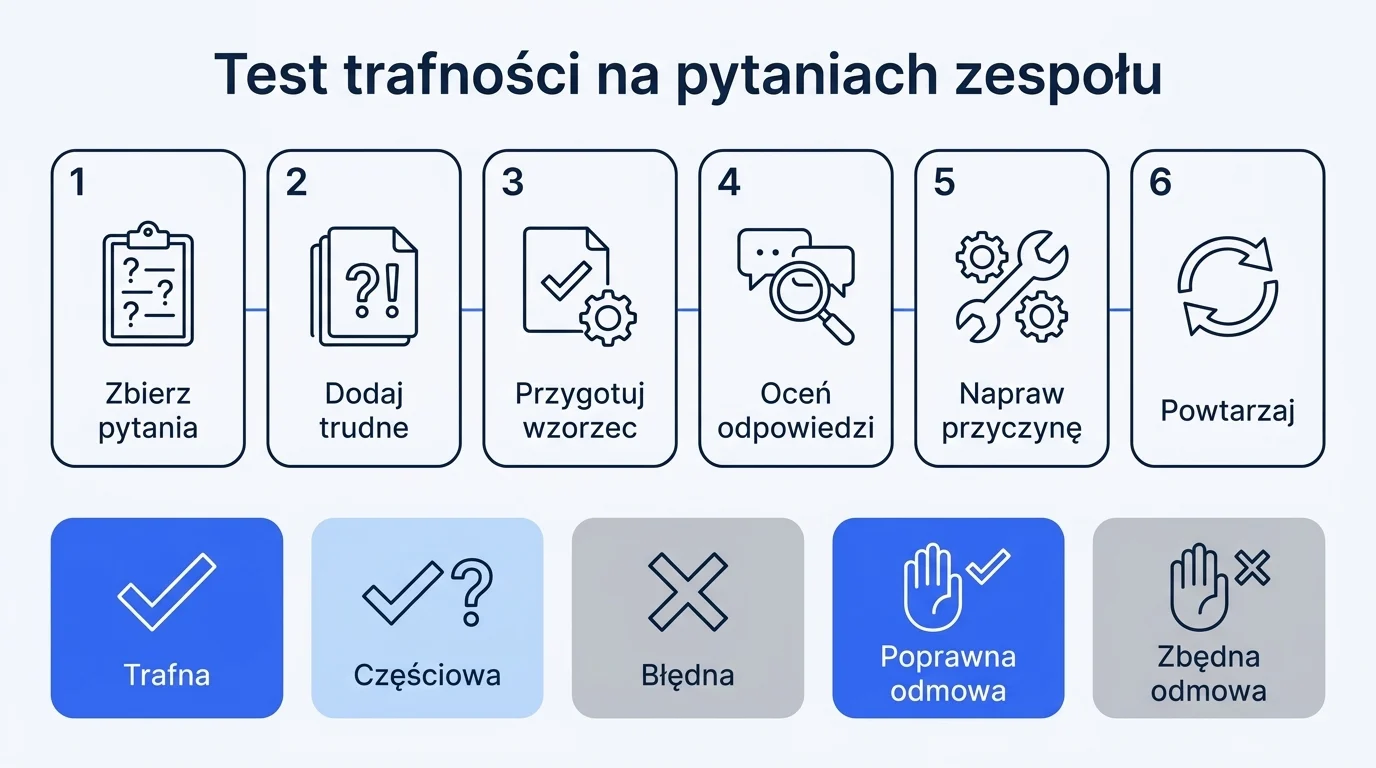
Procedura w sześciu krokach
- Zbierz pytania. Poproś zespół o pytania, które naprawdę padają: z maili, czatów, od nowych pracowników. Proponujemy 20 do 30 pytań na start dla jednego obszaru; to praktyczna rekomendacja, a nie wartość z badań.
- Dodaj pytania trudne. Kilka takich, na które w bazie nie ma odpowiedzi, kilka z wyjątkami („a jeśli klient jest z zagranicy?”) i kilka o liczby i daty.
- Przygotuj wzorzec. Do każdego pytania właściciel treści zapisuje poprawną odpowiedź i dokument, z którego ona wynika.
- Uruchom test i oceń. Zadaj pytania asystentowi i oceń każdą odpowiedź według skali poniżej. Oceniają ludzie, którzy znają temat.
- Napraw przyczynę, nie objaw. Przy każdej złej odpowiedzi ustal, czy winny jest dokument (stara wersja, luka, sprzeczność), wyszukiwanie czy instrukcja asystenta. Najczęściej poprawka trafia do dokumentu.
- Powtarzaj. Ten sam zestaw po każdej większej zmianie w bazie, w instrukcjach lub po zmianie modelu. Nowe pytania z codziennych zgłoszeń dopisuj do zestawu.
| Ocena | Co oznacza | Typowa przyczyna |
|---|---|---|
| Trafna | zgodna ze wzorcem, wskazuje właściwy dokument | baza działa |
| Częściowa | poprawny kierunek, brakuje warunku lub wyjątku | wyjątek niezapisany, dokument pocięty w złym miejscu |
| Błędna | sprzeczna ze wzorcem | stara wersja, sprzeczne dokumenty, zgadywanie |
| Poprawna odmowa | asystent mówi, że nie znalazł odpowiedzi, a w bazie jej rzeczywiście nie ma | dobrze ustawiona instrukcja |
| Zbędna odmowa | asystent nie odpowiada, choć odpowiedź jest w bazie | nieczytelny dokument, skan, zły tytuł |
Zwróć uwagę na czwarty wiersz. Odpowiedź „nie wiem, zapytaj główną księgową” przy pytaniu spoza bazy to sukces, a nie porażka. Asystent, który odpowiada na wszystko, jest groźniejszy niż ten, który czasem odsyła do człowieka.
Próg, przy którym uznajesz obszar za gotowy, ustala firma, bo zależy od stawki. Inny będzie dla podpowiedzi przy pisaniu maili, inny dla odpowiedzi o warunkach umów. Przy pytaniach o pieniądze, prawo i zdrowie rozsądnie jest zakładać, że błędna odpowiedź jest niedopuszczalna, a ostateczną decyzję podejmuje człowiek.
Przykładowy zapis (jeden wiersz arkusza testu): Pytanie: „Jaki termin płatności dostaje nowy klient hurtowy?” | Wzorzec: „14 dni; 30 dni dopiero po trzech terminowo opłaconych fakturach.” | Źródło: Terminy płatności dla klientów hurtowych, wersja 4 | Odpowiedź asystenta: „30 dni.” | Ocena: błędna | Przyczyna: w bazie została wersja 2 regulaminu | Działanie: wersja 2 do archiwum, ponowny test 15.10.2026
Ten sam test pokazuje, czy działa samo wyszukiwanie. Jeśli asystent wskazuje właściwy dokument, ale źle go streszcza, problem leży gdzie indziej niż wtedy, gdy w ogóle go nie znajduje. Jak sprawdzać te dwa etapy osobno, opisuje artykuł RAG po ludzku: jak AI korzysta z dokumentów Twojej firmy.
Od czego zacząć: jeden obszar zamiast całego archiwum
Najczęstszy odruch to „wrzućmy wszystko, AI samo sobie poradzi”. Kończy się bazą, w której stare wersje mieszają się z nowymi, a pierwsze złe odpowiedzi zniechęcają zespół na długo. Lepiej zacząć od jednego obszaru:
- Wybierz jeden obszar, w którym pytania padają często, a błąd kosztuje: obsługa klienta, wdrożenie nowych pracowników, oferty.
- Zrób inwentaryzację materiałów z tego obszaru we wszystkich czterech warstwach, łącznie z pytaniem „kogo pytasz, gdy nie wiesz?”.
- Przejdź listę kontrolną i przypisz właścicieli. Czego nie da się uporządkować teraz, zostaje poza bazą.
- Zbierz pytania testowe, zanim asystent ruszy, żeby mieć punkt odniesienia.
- Uruchom, przetestuj, popraw i dopiero wtedy dołóż kolejny obszar.
Tak wygląda też logika wdrożeń nodash_. W naszym procesie baza wiedzy, czyli mózg całego systemu, powstaje w ramach etapu architektury i implementacji, obok połączeń z narzędziami i porządku w danych.
Po stronie firmy zostaje wskazanie dokumentów i wiedzy, które mają do niej trafić, oraz rozmowy z osobami, które najlepiej znają procesy. Typowe wdrożenie trwa 30 dni, a badanie sytuacji i roadmapa są bezpłatne. Repozytorium i baza wiedzy pozostają własnością Twojej firmy.
Jeśli procedury w Twojej firmie istnieją głównie w głowach ludzi, zacznij od nich, zanim zaczniesz porządkować pliki. Wzór procedury czytelnej dla AI i pytania do wywiadu z ekspertem znajdziesz w tekście Procedury w firmie pod AI: jak spisać wiedzę zespołu (SOP, instrukcje stanowiskowe).
Pięć błędów, które psują bazę już na starcie
- Archiwum w zasięgu asystenta. Folder „stare” obok „aktualne” to zaproszenie do odpowiedzi sprzed lat.
- Skany zamiast tekstu. Podpisany regulamin w PDF ze skanera wygląda porządnie, ale dla wyszukiwania bywa nieczytelny. Do bazy trafia wersja tekstowa, skan zostaje jako dowód.
- Jedna wielka księga. Dokument na 200 stron o wszystkim utrudnia wyszukanie właściwego fragmentu. Lepiej kilka dokumentów, każdy o jednym temacie.
- Brak instrukcji na brak odpowiedzi. Asystent powinien mieć zapisane, że gdy nie znajduje źródła, mówi to wprost i wskazuje osobę do kontaktu. Jak ustawić to i inne zabezpieczenia, opisuje tekst Halucynacje AI: dlaczego AI zmyśla i jak to ograniczyć w firmie.
- Test raz na zawsze. Baza, którą sprawdzono przy uruchomieniu, po pół roku jest inną bazą. Zestaw pytań wraca po każdej większej zmianie.
Częste pytania
Ile dokumentów trzeba, żeby zacząć?
Mniej, niż się wydaje. Liczy się pokrycie pytań z wybranego obszaru, a nie liczba plików. Przy małej bazie nie zawsze potrzeba nawet wyszukiwania: według Anthropic materiał poniżej 200 000 tokenów, czyli około 500 stron, można w jednym zapytaniu przekazać w całości modelowi z odpowiednio dużym oknem kontekstu (wpis z 19 września 2024, sprawdzone 3 października 2026). Porządek, właściciel i test obowiązują niezależnie od tego, jak materiał trafia do modelu.
Czy można po prostu wgrać pliki do ChatGPT?
Do pojedynczego zadania tak, o ile pozwalają na to dane w plikach i plan, z którego korzystasz. Jako stała baza wiedzy zespołu to za mało: pliki nie mają właściciela, statusu ani terminu przeglądu, a każdy wgrywa własną wersję. Co dzieje się z przesłanymi danymi w różnych planach, opisujemy w artykule Czy ChatGPT jest bezpieczny dla firmy? Dane, RODO i ustawienia.
Czy do bazy wiedzy potrzebne jest osobne narzędzie?
Nie musi być. Wiele firm zaczyna od dysku firmowego lub wiki, które już ma, i podłącza je do asystenta. Narzędzie ma znaczenie mniejsze niż to, czy materiały przeszły listę kontrolną i mają właścicieli.