 Radosław Kmita
Odpowiedź dla zabieganych: RAG (retrieval-augmented generation, czyli generowanie wspomagane wyszukiwaniem) to sposób, w jaki AI odpowiada na podstawie dokumentów Twojej firmy. Zanim model napisze odpowiedź, system wyszukuje w Waszych materiałach kilka pasujących fragmentów i podaje mu je razem z pytaniem. Model niczego się przy tym nie uczy na stałe, więc po zmianie dokumentu zmienia się też odpowiedź.
Jakość RAG zależy w dużej mierze od tego, co i w jakim stanie trafiło do wyszukiwarki.
Pamiętasz egzamin z otwartą książką? Nie trzeba było znać wszystkiego na pamięć. Trzeba było szybko znaleźć właściwą stronę i na jej podstawie napisać odpowiedź. RAG robi z modelem językowym dokładnie to: zamienia egzamin z pamięci na egzamin z otwartą książką, a książką są dokumenty Twojej firmy.
Do zrozumienia RAG nie potrzebujesz kodu. Liczą się trzy pytania: co dzieje się w środku, gdzie ten mechanizm się myli i kiedy lepiej wybrać coś innego. Na nie odpowiadamy poniżej.
Co to jest RAG?
RAG to technika, w której model AI przed odpowiedzią dostaje fragmenty wyszukane w wybranych dokumentach i odpowiada na ich podstawie, a nie wyłącznie z tego, co zapamiętał podczas treningu.
Nazwę i architekturę, od której zaczęła się ta technika, opisali w 2020 roku Lewis i współautorzy, badacze m.in. z Facebook AI Research. Połączyli „pamięć” zapisaną w modelu z zewnętrznym indeksem dokumentów, w ich przypadku Wikipedii. Taki model w testach generował bardziej konkretne i lepiej oparte na faktach odpowiedzi niż model korzystający wyłącznie z własnej pamięci.
W firmie zamiast Wikipedii są procedury, cenniki, umowy ramowe, notatki ze spotkań i odpowiedzi na typowe pytania klientów.
Jak działa RAG krok po kroku
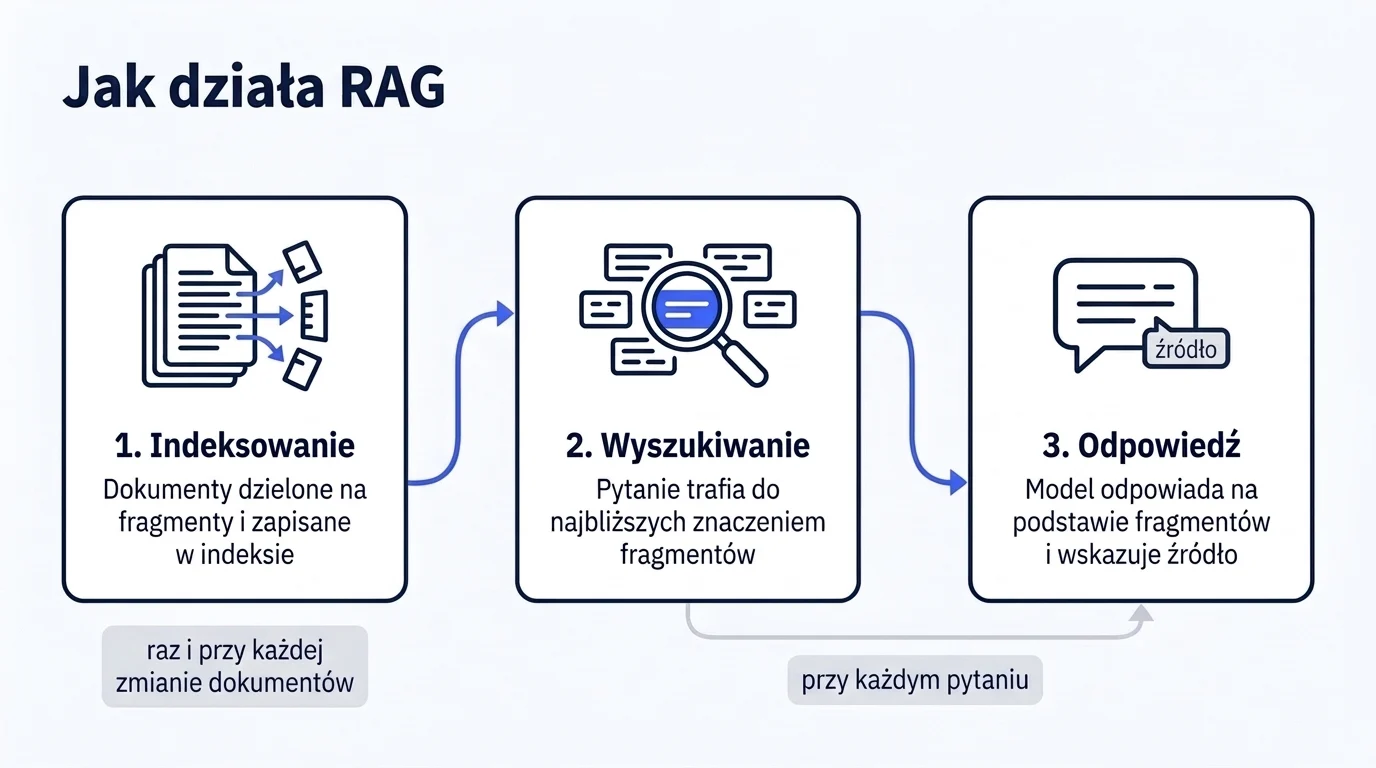
Cały mechanizm ma trzy etapy. Pierwszy dzieje się raz (i przy każdej zmianie dokumentów), dwa kolejne przy każdym pytaniu.
1. Indeksowanie. System dzieli dokumenty na fragmenty, zwykle po kilka akapitów. To cięcie nazywa się chunkingiem. Każdy fragment dostaje „odcisk znaczenia”, czyli embedding: ciąg liczb opisujący, o czym jest tekst. Odciski trafiają do bazy wektorowej, czyli bazy danych, która potrafi szybko znaleźć teksty podobne znaczeniem, a nie wyłącznie z tymi samymi słowami.
2. Wyszukiwanie. Pytanie użytkownika też dostaje swój odcisk. System wybiera kilka fragmentów o najbliższym znaczeniu. Na tym polega wyszukiwanie semantyczne: pytanie „ile mamy na zwrot?” może trafić we fragment „Termin na odstąpienie od umowy wynosi…”, choć słowo „zwrot” w nim nie pada. Wiele systemów łączy to z klasycznym wyszukiwaniem po słowach kluczowych.
3. Odpowiedź. Model dostaje pytanie, wybrane fragmenty i instrukcję w rodzaju „odpowiadaj na podstawie poniższych materiałów i wskaż źródło”. Dopiero wtedy pisze odpowiedź.
Przykład ilustracyjny. Procedura „Reklamacje klientów B2B” ma cztery strony. Po indeksowaniu staje się, powiedzmy, sześcioma fragmentami: zakres, terminy, wymagane dokumenty, ścieżka akceptacji, wyjątki dla klientów kluczowych, kontakt. Handlowiec pyta: „Czy klient kluczowy może zgłosić reklamację po 30 dniach?”. Wyszukiwarka powinna podać modelowi fragment o terminach i fragment o wyjątkach. Jeśli poda tylko pierwszy, odpowiedź będzie poprawna dla zwykłego klienta i błędna dla tego, o którego pytano.
Z tego przykładu wynika najważniejsze: model odpowiada na podstawie tego, co dostał. Nie widzi całej procedury, tylko wybrane kawałki.
Co RAG musi dostać od Twojej firmy
RAG nie porządkuje wiedzy, tylko ją przeszukuje. Jeśli w folderze leżą trzy wersje cennika, wyszukiwarka może podać modelowi każdą z nich. Dlatego przygotowanie dokumentów to osobna praca: jedna obowiązująca wersja, właściciel treści, tekst przeszukiwalny zamiast skanu, opisowe nagłówki.
Pełną listę kontrolną i model odpowiedzialności za treści opisujemy w artykule Baza wiedzy dla AI: jak przygotować dane firmy, żeby AI odpowiadało trafnie. Tutaj zostańmy przy tym, co się dzieje, gdy tej pracy zabraknie.
Dlaczego RAG nie zawsze zna odpowiedź
RAG najczęściej myli się nie dlatego, że model jest słaby, tylko dlatego, że wyszukiwarka podała mu złe, niepełne albo sprzeczne fragmenty. Większość awarii naprawia się w dokumentach i w sposobie ich indeksowania, a nie przez zmianę modelu.
| Co widzisz | Co się stało | Co poprawić |
|---|---|---|
| Odpowiedź pomija wyjątek albo warunek | Fragment z wyjątkiem nie trafił do wyszukanych, bo cięcie rozdzieliło regułę od jej warunku | Pisać wyjątki obok reguły, nadawać sekcjom opisowe nagłówki |
| AI podaje starą stawkę lub termin | W indeksie są stare wersje dokumentu | Jedna obowiązująca wersja, archiwum poza indeksem, data przeglądu |
| Dwie różne odpowiedzi na to samo pytanie | Dokumenty sobie przeczą | Wskazać dokument nadrzędny, usunąć duplikaty |
| „Nie znalazłem informacji”, choć ona jest | Inne słownictwo w pytaniu i w dokumencie, skróty bez wyjaśnienia, skan bez warstwy tekstu | Słowniczek nazw i skrótów, rozpoznanie tekstu w skanach |
| Błędna suma lub zestawienie | Pytanie wymaga policzenia danych z wielu miejsc, a RAG podaje kilka fragmentów | Do liczb i stanów bieżących połączyć AI z systemem źródłowym |
| Pracownik widzi fragment, do którego nie ma dostępu | Indeks nie respektuje uprawnień z systemów źródłowych | Uprawnienia na poziomie dokumentów w indeksie, przed uruchomieniem |
Pierwszy wiersz to najczęstszy kłopot z cięciem dokumentów. Fragment wyrwany z kontekstu traci informację, do czego się odnosi.
Anthropic w poście o Contextual Retrieval z września 2024 opisał, że dopisanie do każdego fragmentu krótkiego kontekstu przed indeksowaniem zmniejszyło odsetek nieudanych wyszukiwań (wśród 20 najlepszych fragmentów) o 35 procent, z 5,7 do 3,7 procent. Po połączeniu z wyszukiwaniem po słowach kluczowych spadek wyniósł 49 procent, a z dodatkowym sortowaniem wyników 67 procent.
To wyniki na zbiorach testowych firmy (kod, literatura, publikacje naukowe), a nie gwarancja dla Twoich dokumentów, ale dobrze pokazują, ile zależy od przygotowania tekstu.
Dobrze napisana procedura sama ogranicza część tych awarii, bo wyjątki stoją przy regułach, a każda sekcja jest zrozumiała bez reszty dokumentu. Jak taką procedurę spisać, pokazujemy w artykule Procedury w firmie pod AI: jak spisać wiedzę zespołu (SOP, instrukcje stanowiskowe).
Piąty wiersz wymaga wyjaśnienia. RAG dobrze odpowiada na pytanie „jak?”, słabiej na „ile?”. Pytanie o liczbę nieopłaconych faktur to zadanie dla połączenia z systemem księgowym, a nie dla wyszukiwania w dokumentach. Takie połączenia opisujemy w artykule MCP (Model Context Protocol): jak AI łączy się z narzędziami firmy.
Pytania o liczby z arkuszy, CRM i Excela opisujemy osobno w tekście Rozmowa z danymi: jak pytać AI o sprzedaż, CRM i Excela zamiast budować dashboardy.
RAG, fine-tuning czy cały dokument w prompcie?
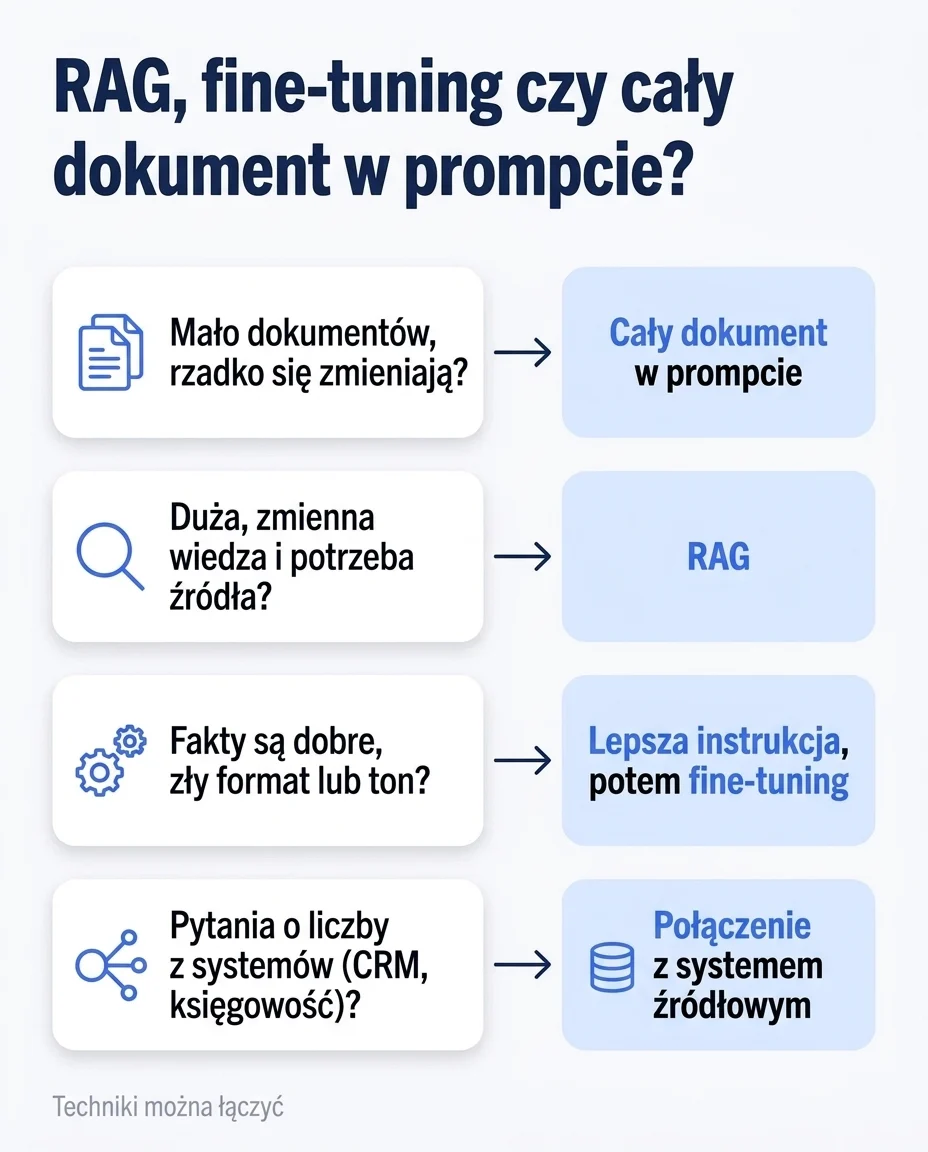
Jeśli AI ma znać fakty z Twoich dokumentów, zacznij od RAG albo od wstawienia dokumentów do promptu. Fine-tuning służy przede wszystkim do zmiany zachowania modelu (formatu, tonu, sposobu wykonywania zadania), a nie do dopisywania wiedzy.
Tak rozdziela te techniki przewodnik OpenAI o poprawie trafności modeli: RAG daje modelowi kontekst z Twojej dziedziny, a fine-tuning (dostrajanie, czyli dodatkowy trening na przykładach) poprawia spójność wykonania zadania. Przewodnik podkreśla też, że techniki można łączyć.
Podobny wniosek płynie z badania Ovadii i współautorów: w ich testach RAG konsekwentnie wypadał lepiej niż nienadzorowany fine-tuning przy dodawaniu wiedzy, a modele słabo przyswajały w ten sposób nowe fakty. Badanie dotyczyło jednej odmiany dostrajania, więc nie przenoś tego wniosku na każdą.
Trzecia droga jest najprostsza. Jeśli materiałów jest mało, można je w całości wstawić do promptu. Anthropic we wspomnianym poście z 2024 roku wskazywał próg około 200 000 tokenów, czyli według firmy mniej więcej 500 stron.
Długi kontekst ma jednak słaby punkt: Liu i współautorzy pokazali w 2023 roku, że modele lepiej korzystają z informacji na początku i na końcu długiego tekstu niż w jego środku. Nowsze modele mogą radzić sobie lepiej, ale warto to sprawdzić na własnych pytaniach.
| Pytanie decyzyjne | Jeśli „tak”, rozważ | Co utrzymujesz | Główne ryzyko |
|---|---|---|---|
| Materiałów jest niewiele (rząd kilkuset stron) i rzadko się zmieniają? | Cały dokument w prompcie | Aktualny plik lub pakiet plików | Koszt każdego pytania, gubienie informacji ze środka |
| Wiedza jest duża, rozproszona i często się zmienia? | RAG | Porządek w dokumentach, indeks, uprawnienia | Złe fragmenty, stare wersje w indeksie |
| Odpowiedzi muszą wskazywać źródło? | RAG lub prompt z oznaczonymi dokumentami | Nazwy i wersje dokumentów | Źródło podane, a treść źle odczytana |
| Model zna fakty, ale pisze w złym formacie lub tonie? | Najpierw lepsza instrukcja i przykłady, potem fine-tuning | Zestaw przykładów treningowych | Koszt i ponowny trening przy każdej zmianie |
| Chcesz, żeby model „nauczył się” Waszych cen i procedur? | RAG, nie fine-tuning | Jak przy RAG | Dostrojony model odpowiada pewnie, ale ze starych danych |
| Pytanie dotyczy liczb i stanów z systemów (CRM, księgowość)? | Połączenie z systemem źródłowym | Integracje i uprawnienia | Wyszukiwanie w dokumentach zamiast odczytu danych |
Stan dokumentacji i źródeł w tabeli: zweryfikowano 3 października 2026.
W praktyce małej i średniej firmy pytanie rzadko brzmi „RAG czy fine-tuning”. Częściej brzmi: czy nasze dokumenty są w stanie, w którym jakakolwiek z tych metod da dobre odpowiedzi.
Czy RAG eliminuje halucynacje?
Nie. RAG zmniejsza ryzyko zmyślania, bo daje modelowi materiał źródłowy, ale go nie usuwa. Model może źle odczytać fragment, połączyć dwa niepasujące albo dopowiedzieć brakujący szczegół, gdy wyszukiwarka nic nie znajdzie. Pomaga instrukcja, żeby przyznawał się do braku informacji, oraz wymóg podawania źródła przy każdej odpowiedzi. Przyczyny i pełny zestaw środków zaradczych opisujemy w artykule Halucynacje AI: dlaczego AI zmyśla i jak to ograniczyć w firmie.
Gdzie trafiają dane, gdy działa RAG?
W systemie RAG Twoje dokumenty są przechowywane w indeksie, a przy każdym pytaniu wybrane fragmenty trafiają do modelu, który pisze odpowiedź. To dwa osobne miejsca. Dla każdego ustalcie, kto jest dostawcą, gdzie dane leżą i na jakich warunkach.
Przy własnym systemie na API trzy pytania porządkują rozmowę z wykonawcą. Gdzie fizycznie stoi indeks i kto ma do niego dostęp? Jakie fragmenty i do jakiego dostawcy modelu wysyłamy przy pytaniu? Czy indeks respektuje uprawnienia, które dokumenty mają w systemach źródłowych? Odpowiedzi nie zastąpią oceny prawnej, gdy w dokumentach są dane osobowe. Warunki popularnych narzędzi i planów opisujemy w artykule Czy ChatGPT jest bezpieczny dla firmy? Dane, RODO i ustawienia.
Jak sprawdzić, czy RAG w Twojej firmie działa
Nie oceniaj po pierwszym wrażeniu z prezentacji. Zbierzcie prawdziwe pytania, które zespół zadaje sobie nawzajem, dopiszcie do każdego wzorcową odpowiedź i dokument źródłowy, a potem oceńcie odpowiedzi systemu: trafna, częściowa, błędna albo uczciwa odmowa. Test powtarzacie po każdej większej zmianie dokumentów.
Przy ocenie patrzcie osobno na dwie rzeczy: czy wyszukiwarka znalazła właściwy fragment i czy model dobrze go wykorzystał. To podpowiada, co naprawiać, dokumenty czy instrukcję. Procedurę testu z kryteriami oceny znajdziesz w artykule Baza wiedzy dla AI: jak przygotować dane firmy, żeby AI odpowiadało trafnie.
Najczęstsze pytania
Czy RAG wymaga trenowania modelu?
Nie. W RAG model pozostaje taki, jaki dostajesz od dostawcy. Zmienia się tylko to, co dostaje przed odpowiedzią: wyszukane fragmenty Waszych dokumentów. Trenowanie (fine-tuning) to osobna technika, opisana w tabeli wyżej.
Czy RAG to to samo co wgranie plików do czatu?
Mechanizm bywa podobny, bo czaty z funkcją plików też wyszukują fragmenty przed odpowiedzią. Różnica leży w kontroli: we własnym systemie decydujecie, które dokumenty są w indeksie, jak są aktualizowane, kto widzi który dokument i jak wygląda źródło przy odpowiedzi. W czacie z wgranymi plikami zwykle każdy użytkownik zarządza swoimi plikami sam.
Czy RAG poradzi sobie ze skanami i plikami PDF?
Z PDF z warstwą tekstową zazwyczaj tak. Skan to dla wyszukiwarki obrazek, więc najpierw trzeba rozpoznać w nim tekst (OCR) i sprawdzić jakość tego rozpoznania, szczególnie w tabelach i liczbach.